人民日报、政府工作报告、五年规划:Stage 1 + Stage 2 已执行。
01 / WHY NOW Source snapshot · 81aaba0 · 2026.08.20
903 份结构化全文文件,可继续按工具、主体和定量承诺重读。
资料已经获得;正在处理去重、字段、实体、时间与地域对齐。
最终 N、唯一实体数、可比年份与变量定义必须由具体研究问题决定。
当前位置:基础设施 → 第一个可信分析
以北大法宝等政策数据库为来源,使用 Boolean logic 建立候选,再按研究目的纳入。
既有研究提供起始词;历史语料和迭代审查补充时代变体。
| 方法来源 | 提供了什么 | 本项目怎样使用 | 没有声称什么 |
|---|---|---|---|
| Nan et al. (2020) | 政策数据库与 Boolean 检索范式 | 作为检索和纳入逻辑的实证锚点 | 不做简单规模倍数比较 |
| 老龄政策相关文献 | 概念边界与主题词 | 形成跨时期关键词家族 | 文献词表不是最终真值 |
| 历史语料审查 | 旧称、制度语言与边缘表达 | 降低现代词汇造成的历史遗漏 | 关键词命中不等于政策相关 |
在特定研究期、检索式与纳入目的下形成的路径
共同原则有文献依据的召回 → 按研究目的判断
扩大关键词与状态范围;高密度全文和低密度材料走不同路线
关键词召回语义筛选段落证据
报刊、报告、规划:相关内容只占大语料的一小部分。
文件分流结构提取全文索引
法规与专项政策:需要保留完整制度结构和上下文。
审计对齐连接面板
统计、服务、CHARLS/CLHLS:关键是口径、实体、时间和变量可比。
候选段落 · 高召回
保留 relevant + partial
full_log 有效段落
| Stage | 主要责任 | 主要错误 | 修正路线 |
|---|---|---|---|
| 1 | 保护召回,减少历史语言遗漏 | 噪音与假阳性 | 迭代词表、上下文窗口、Stage 2 |
| 2 | 语义相关性与基础结构 | 边界判断、漏判与标签漂移 | 校准样本、人工挑战、协议版本 |
示意原文 · 非实际引文
各地应完善居家和社区养老服务网络,支持符合条件的机构参与服务供给,并逐步提高基本养老服务可及性……
- decision
- relevant
- summary
- 完善居家社区服务网络并提高可及性
- tags
- home_based · community · provider · access
- quantitative_info
- unknown
- provenance
- source_id · year · passage_id · prompt_version
各地应逐步建立以居家为基础、社区为依托、机构为补充的养老服务体系,完善服务设施和支持政策……
此文本仅用于演示界面逻辑,不作为项目语料引文。起点当前 Stage 2 基础 record相关性 · 摘要 · 基础标签 · 定量线索 · provenance
VALIDATION
PROMPT v0.xMODEL + DATECALIBRATION SETALLOWED UNKNOWNSPROVENANCE
概念SCHEMA校准样本运行误差审查批准 / 修订
重复运行一致性
不是准确率| 必须记录 | 为什么 |
|---|---|
| protocol / schema version | 知道模型被要求做什么 |
| 校准与人工判断 | 把稳定与正确分开 |
| 主要错误类型 | 决定是否可以用于具体结论 |
原始保留
北京 / 北京市 / 110000
机构 A / A 养老院 / A 老年公寓
2013 created_at / 2024 snapshot
duplicate package · changing headers
对齐
分析结构
geo_id · province · city · county
entity_id · source_record_id · match_status
observation_date · creation_date · source_vintage
variable_definition · provenance · qa_flag
为什么这一步快,但不能省
AI 可以协助发现重复、异名和字段模式;研究者仍要决定什么算同一实体、哪个时间口径对应研究问题。
以往的可执行边界
先收窄,才能读完- 少量文件
- 较早排除
- 一次性编码
- 重跑成本高
现在的可执行边界
先宽召回,再逐层判断- 保留候选宇宙
- 机器辅助重读
- 协议可版本化
- 人类校准与挑战
不是设想:核心管线已经执行
240,984 候选段落
76,656 有效段落
903 结构化全文
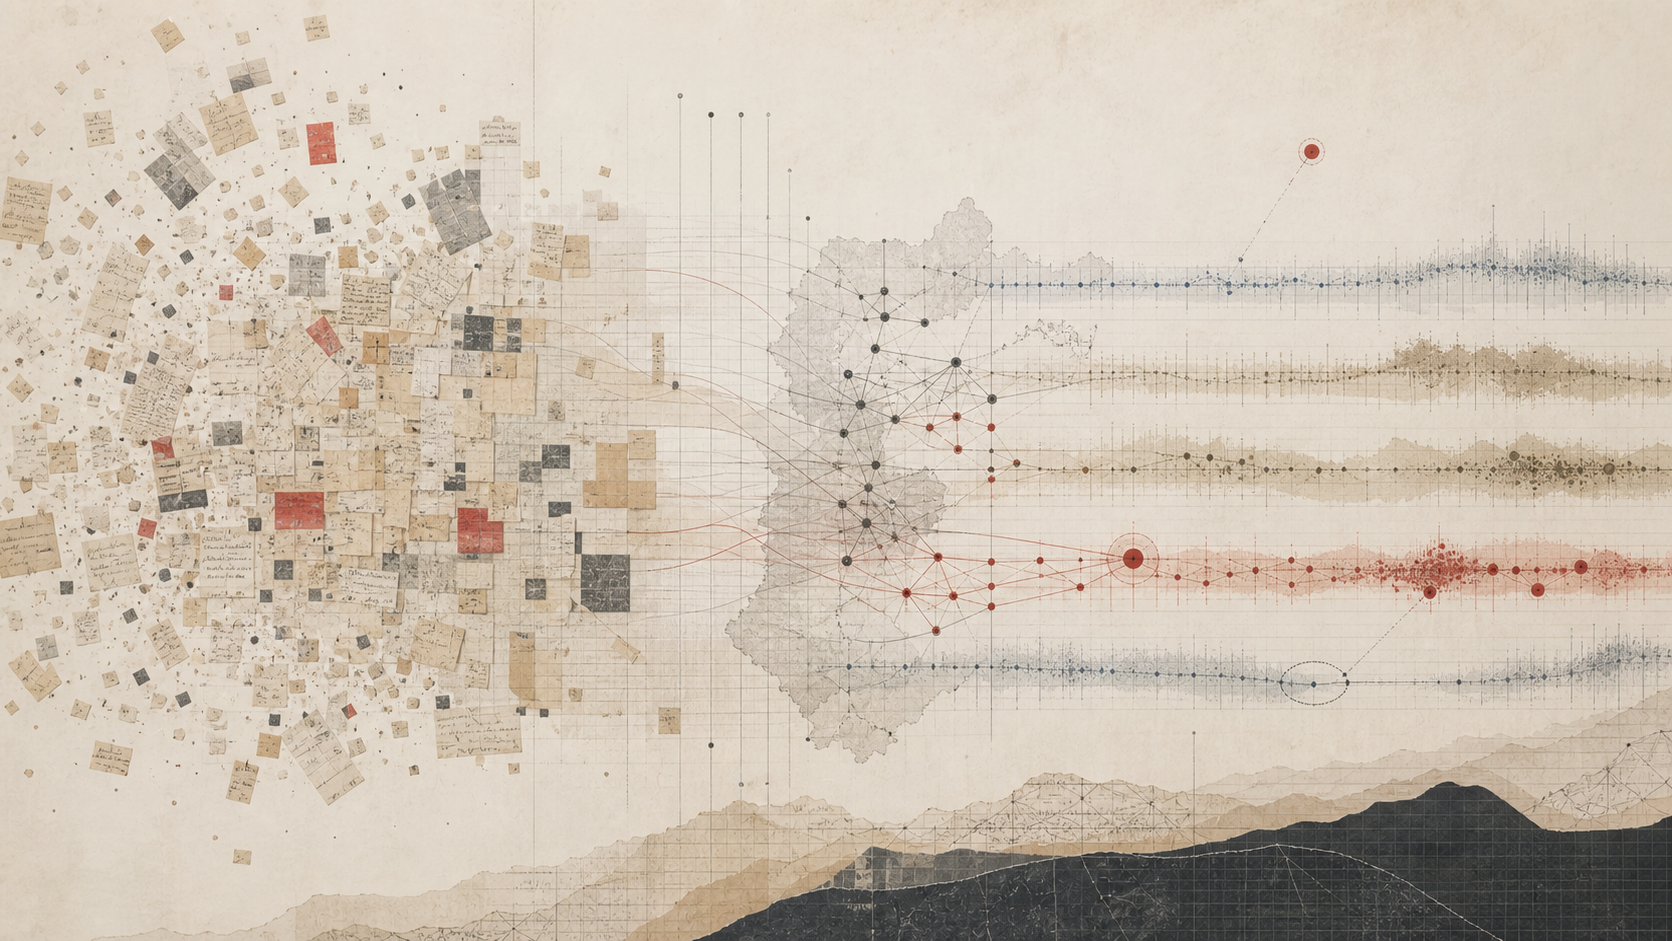
共享证据基础
可以反复提问
保留来源、时间、地域和处理血缘
用新的协议从同一原文提取不同证据
把人工判断、错误和变量定义写回系统
| 价值层 | 一次性项目 | 持续研究引擎 |
|---|---|---|
| 效率 | 每个题目重复整理 | 基础处理可以复用 |
| 覆盖 | 为单一问题较早收窄 | 保留更大的候选空间 |
| 可重读 | 编码完成后难以改变 | 同一原文可应用新协议 |
点开任一层,查看它能回答什么、覆盖到哪里、不能代表什么。
文件、表格、扫描件、调查包
保留候选,建立来源和字段
段落、全文、指标和调查变量
概念、比较、机制与可检验关系
已进入核心管线
已收集,待组织/处理
覆盖不均或需核查
历史结构性缺席
194619601980200020202025
人民日报1946–2024
法规 / 正式政策1951–2024 · 覆盖不均
中央政府报告1954–2024 · 有结构性缺年
光明日报1985–2023 · 缺 1989
中国青年报2005–2023 · 后期产量下降
南方周末 / 经济日报2008–2025
人民政协报2008–2023
30 省级日报2007–2024 · 各省不一
CLHLS1998–2021
CHARLS2011–2020
养老服务登记创建时间主要 2013–2024
| 资料 | 覆盖 | 主要作用 | 必须保留的限制 |
|---|
所有数字按来源单位分别呈现;点击大数字查看定义与口径。
- INPUT
- OUTPUT
- 人工 GATE
已完成 / 已执行下一步需验证后续能力
共同骨架:问题定义 → Reading Protocol → 来源追踪 → 人工挑战 → 修正
共享核心证据基础 · Reading Protocol · 验证集 · 分析 Skill
理论、问题、论证强度与学术方向
概念、制度语境与边界案例
测量、比较、识别与稳健性
处理管线、协议执行、可追溯输出
- 可用覆盖
- 可以问
- 进入分析前
- 不能直接声称
调整任一约束会改变四个研究窗口的匹配度;窗口仍可点击查看覆盖、准备工作和当前不能支持的主张。
| 研究窗口 | 覆盖匹配 | 概念清晰 | 清理范围 | 证据链 | 识别 / 时效难度 |
|---|---|---|---|---|---|
| 长期概念与政策注意力 | ●●● | ●●○ | ●●● | ●●○ | 中 |
| 中央—地方政策转译 | ●●● | ●●○ | ●●○ | ●●● | 中 |
| 政策—供给 gap | ●●○ | ●●○ | ●○○ | ●●● | 中—高 |
| 长护险与个体结果 | ●●○ | ●●● | ●○○ | ●●● | 高 · 数据相对滞后 |
题目值得团队投入,并能与现有研究议程衔接。
即使没有预期关系,也能得到可解释、可报告的结论。
核心变量、比较单位和证据来源都可以被清楚核验。
清理、验证与首轮分析可以在约定周期内形成闭环。
需要 PI 判断
- 理论镜头是否遗漏重要维度?
- 哪个问题具有最清楚的学术增量?
- 现有证据允许描述、机制还是因果主张?
- 哪些同事、受众和期刊最适合第一项研究?
这不是最终评分;它把选择研究题目时必须讨论的 trade-off 放到同一张桌上。
- 01
这个框架最重要的盲点是什么?
- 02
哪个问题具有最清楚的学术增量?
- 03
现有证据允许我们做多强的主张?
- 04
哪些同事适合组成第一个小组?
- 05
第一项产出面向什么 audience / journal?
清理 / 对齐共同选题分析 / 验证发表 / 复用
从 75 年的材料,走向第一个可信、可解释、可复用的发现。